Claude Fable과 Mythos 5.2, 성능보다 먼저 볼 선택 기준

Claude Fable 5.2와 Mythos 5.2 중 무엇을 골라야 할까요? Anthropic의 2026년 11월 9일 발표에 따르면 두 제품은 같은 기반 모델을 씁니다. 선택을 가르는 것은 모델 크기의 차이가 아니라 사이버보안, 생물학 안전장치와 접근 조건입니다.
일상적인 코딩부터 더 어려운 기술 작업으로 넘어가는 경우와, 보안, 생명과학 연구를 수행하는 경우는 출발점이 다릅니다. 가격표와 벤치마크를 보기 전에 이 구분을 해야 같은 모델이라는 설명이 실제 사용 가능 범위와 혼동되지 않습니다.
같은 모델이어도 허용되는 작업은 다릅니다
Anthropic은 Fable에 사이버보안과 생물학 악용을 막는 강한 안전장치를 적용해 일반 사용자에게 제공한다고 설명합니다. Mythos는 이 분야에서 유익한 작업을 수행하는 조직이 검증 프로그램을 거쳐 접근하는 모델입니다. 보안 분야에는 Cyber Verification Program, 생명과학 분야에는 Life Sciences Verification Program이 있습니다.
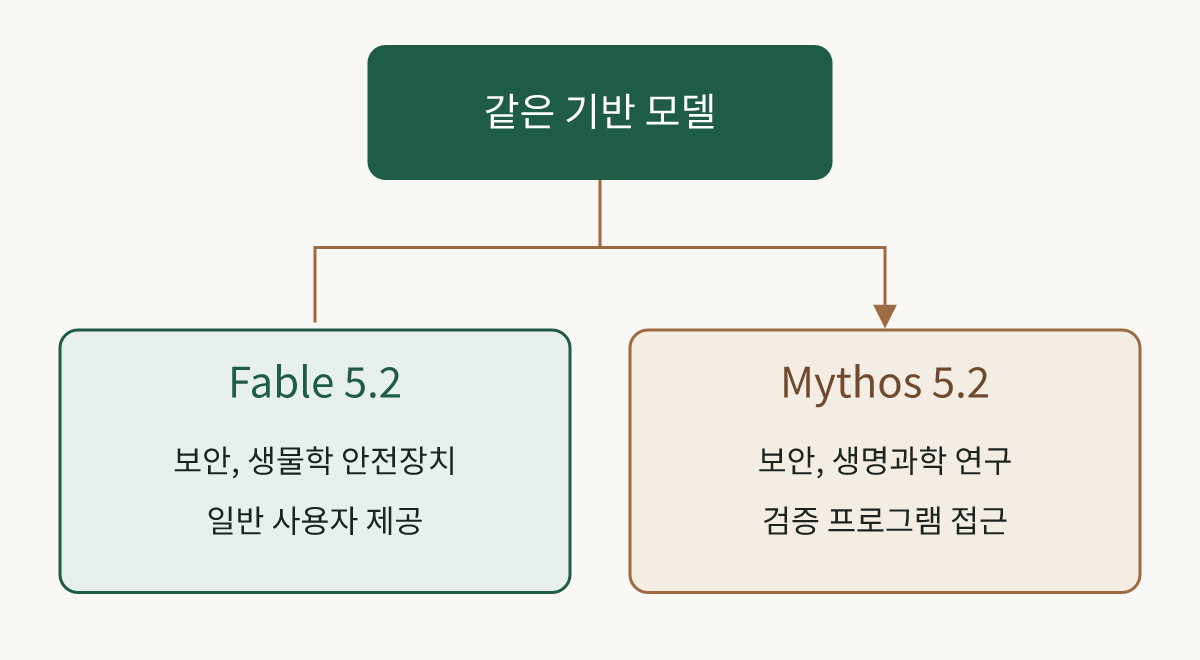
발표문은 Fable이 침투 테스트, 익스플로잇 생성 같은 고위험 보안 활동과 대부분의 연구 생물학 작업을 차단한다고 밝힙니다. 차단된 질의에는 보안 분야에서 Opus 4.8, 생물학 분야에서 Opus 5가 대신 응답합니다. 따라서 Fable을 선택했다는 사실만으로 모든 응답이 Fable에서 나온다고 볼 수는 없습니다.
Anthropic은 Fable 5.2가 5.1보다 불필요한 차단을 줄였다고 설명하지만, 이것이 보안, 생물학 작업 제한을 없앴다는 뜻은 아닙니다. 이 분야의 작업이라면 성능 순위보다 검증 프로그램의 접근 조건이 먼저입니다.
일반 작업의 출발점은 여전히 Opus입니다
발표문의 모델 선택 안내는 대부분의 코딩과 지식 작업을 Opus 5.5로 시작하라고 권합니다. 그다음 작업 범위와 복잡도에 따라 Fable, Mythos로 올리거나 Sonnet, Haiku로 내리는 방식입니다. Fable과 Mythos는 가장 어렵고 정답이나 진행 경로가 미리 정해지지 않은 기술 작업에 배치합니다.
항상 가장 큰 모델이 전체 작업을 맡아야 하는 것도 아닙니다. Anthropic은 Fable을 작은 모델이 어려운 문제에서 조언을 구하는 Advisor, 또는 쉬운 작업을 작은 모델에 위임하는 Orchestrator로 사용할 수 있다고 설명합니다. 이는 모델 하나를 고르는 문제와 작업별로 모델을 배치하는 문제를 구분하게 합니다.
토큰 단가와 완료 시간은 다른 지표입니다
Anthropic이 발표한 두 모델의 가격은 다음과 같습니다. 금액은 미국 달러이며 입력과 출력 각각 100만 토큰 기준입니다.
| 모드 | 입력 가격 | 출력 가격 | 발표문이 설명하는 속도 변화 |
|---|---|---|---|
| 일반 | $8 | $40 | 각각의 5.1 모델보다 출력 생성 최대 30% 빠름 |
| Fast | $16 | $80 | 선택형 fast mode로 토큰 생성 최대 2.5배 가속 |
두 속도 수치는 Anthropic의 발표에 따른 것으로, 비교 기준과 의미가 다릅니다. 최대 30%는 이전 버전 대비 출력 생성 속도이고, 최대 2.5배는 fast mode의 토큰 생성 가속입니다. 어느 쪽도 도구 호출과 검토까지 포함한 전체 작업이 같은 비율로 빨라진다는 뜻은 아닙니다.
토큰 가격만으로 작업당 비용도 결정되지 않습니다. 발표문은 FrontierCode 2.0 초기 평가에서 Fable 5.2의 High effort 점수가 Opus 5.5의 Max effort 점수와 비슷하면서 작업당 비용은 약 절반이었다고 보고합니다. 이는 특정 평가와 effort 설정에서의 결과이지, 모든 코딩 작업의 비용을 절반으로 줄인다는 보장은 아닙니다.
Fast mode의 제공 경로도 별도로 봐야 합니다. 발표 당시 지원 대상으로 나열된 곳은 Claude Code, Claude Platform, Google Cloud의 Claude Models, Microsoft Foundry의 Anthropic 호스팅입니다. Mythos fast mode 역시 검증 프로그램에 속한 조직만 접근할 수 있습니다.
벤치마크에서는 설정과 평가 범위를 함께 봅니다
Anthropic이 공개한 FrontierCode 2.0 점수는 Fable 5.2가 Xhigh effort에서 49.1%, Fable 5.1이 Xhigh effort에서 32.4%, Opus 5.5가 45.5%입니다. 이 평가는 오픈소스 저장소 관리자가 모델의 코드 변경을 병합할 만한지 측정합니다. 실제 서비스의 장애율이나 특정 팀의 개발 생산성을 측정한 수치는 아닙니다.
같은 표 안에서도 조건이 달라집니다. 발표문은 별도 표기가 없으면 가장 높은 effort를 사용했고 Fable과 Opus 점수는 안전장치를 켠 결과라고 명시합니다. 반면 사이버보안 항목에는 Mythos 점수와 안전장치를 끈 Opus 점수가 등장합니다. 특히 CyScenarioBench는 연구소마다 서로 다른 과제를 사용했다고 밝혀, 숫자를 동일한 시험의 순위처럼 읽어서는 안 됩니다.
안전성 평가도 점수 하나로 끝나지 않습니다. Anthropic은 일부 평가에서 모델이 평가받고 있음을 의심하는 빈도가 높아 실제 환경의 행동을 판단하기 어렵다고 설명합니다. 외부 평가 기관들이 출시 전 테스트에 참여했지만, 발표문 각주는 그 기관들이 발표문이나 시스템 카드의 내용을 검토한 것은 아니며 주장에 동의한다고 볼 수도 없다고 명시합니다. 평가 방법의 세부 사항은 시스템 카드에 연결되어 있습니다.
선택 순서는 접근 조건, 작업 난도, 속도입니다
발표문이 제시하는 선택 순서는 분명합니다. 일반적인 코딩, 지식 작업은 Opus에서 시작하고, 더 어려운 기술 작업에 Fable을 고려합니다. 보안, 생명과학 작업은 Mythos 검증 프로그램의 접근 조건부터 확인해야 합니다.
그다음에 일반 모드와 fast mode의 단가, 실제로 필요한 토큰 생성 속도를 비교할 수 있습니다. 같은 기반 모델이라는 설명은 두 제품의 출발점을 알려 주지만, 안전장치, 접근 권한, 실행 설정까지 같다는 의미는 아닙니다.
출처
- Anthropic: Introducing Claude Fable 5.2 and Claude Mythos 5.2 — 2026년 11월 9일 발표, 11월 11일 수정 표기
- Cyber Verification Program
- Life Sciences Verification Program